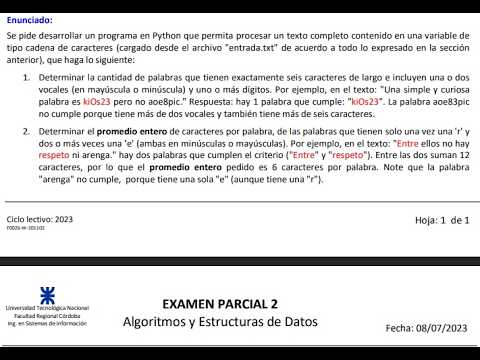
Esto son algunos de los ejercicios y trabajos practicos y parciales realizados en mi Etapa de dictado de clases particulares de materias de programación de la Universidad Tecnologica Nacional en la materia Algoritmo y Estructura de Datos, Paradigmas de la Programación
Los ejercicios estos eran con los que hacíamos y con los cuales explicaba directamente a mis distintos estudiantes que tenía a cargo Algunos de los conceptos que realizamo fueron:
Optimización de flujo de control: Uso adecuado de if, elif, y else para maximizar la eficiencia y legibilidad del código. Evitar la anidación excesiva: Preferencia por la utilización de operadores lógicos (and, or) para combinar condiciones, y reducir la complejidad. Priorizar el uso de guard clauses: Implementación de condiciones de salida temprana para evitar ramas anidadas innecesarias.
Selección adecuada del bucle: Uso de for cuando el número de iteraciones es conocido, y while cuando la iteración depende de una condición que puede cambiar en cada ciclo. Evitar bucles infinitos: Implementación cuidadosa de condiciones de terminación para evitar que los bucles while se ejecuten indefinidamente. Uso de break y continue: Control preciso del flujo dentro de los bucles para mejorar la eficiencia y claridad.
Descomposición del problema: División del código en funciones y módulos pequeños y cohesivos que realizan tareas específicas. Reutilización de código: Creación de funciones reutilizables y de propósito general, evitando la duplicación de código. Manejo de dependencias: Reducción de acoplamiento entre módulos para facilitar el mantenimiento y las pruebas del código.
Flujo de ejecución: Comprensión de cómo la máquina interpreta y ejecuta el código, desde la carga de variables en la memoria hasta la finalización del programa. Jerarquía de operadores: Dominio de la precedencia de operadores para evitar errores lógicos en las expresiones complejas.
Diseño de funciones recursivas: Creación de funciones que se llaman a sí mismas con un caso base claro para evitar bucles infinitos. Análisis de la complejidad recursiva: Evaluación de la eficiencia de las soluciones recursivas en comparación con las iterativas. Paso de parámetros y retorno de valores: Implementación efectiva de funciones que reciben entradas y retornan resultados, maximizando la reutilización.
Análisis de la complejidad temporal y espacial: Evaluación del rendimiento de algoritmos en términos de tiempo de ejecución y uso de memoria. Mejora de la eficiencia: Refinamiento de algoritmos para reducir su complejidad a través de técnicas como la eliminación de bucles innecesarios o el uso de estructuras de datos más adecuadas.
Manipulación y acceso a datos en matrices: Creación, acceso y modificación de elementos dentro de matrices unidimensionales y multidimensionales. Optimización del espacio en matrices: Uso de técnicas como la matriz dispersa para reducir el uso de memoria cuando hay muchos valores nulos.
Conversión de datos tabulares en objetos: Creación de instancias de clases a partir de datos CSV, mapeando cada fila a un objeto con atributos específicos. Sin uso de pandas: Implementación manual de este mapeo para demostrar comprensión profunda de la lógica detrás del manejo de datos y objetos.
Modelado de datos: Interpretación de requisitos y reglas de negocio para diseñar clases y objetos que reflejen estructuras lógicas derivadas de enunciados de problemas. Aplicación de patrones de diseño: Uso de patrones como Factory Method o Builder para instanciar objetos de manera flexible y escalable.
Serialización y deserialización de objetos: Uso de pickle para convertir objetos en un formato binario que puede ser almacenado y recuperado desde archivos. Consideraciones de seguridad: Comprensión de los riesgos asociados con la deserialización de datos no confiables y cómo mitigarlos.
Creación eficiente de arrays: Elección de arrays sobre otras estructuras de datos cuando el acceso por índice constante es necesario. Operaciones avanzadas en arrays: Implementación de operaciones como búsqueda, ordenamiento y manipulación de arrays en aplicaciones de alto rendimiento.
Acceso y modificación de elementos: Técnicas para acceder, actualizar y manipular objetos almacenados en arrays. Optimización del rendimiento: Minimización del tiempo de ejecución en operaciones de edición a través del uso de arrays y métodos eficientes.
Búsqueda secuencial: Implementación y análisis de la búsqueda en arrays no ordenados. Búsqueda binaria: Aplicación de la búsqueda binaria en arrays ordenados para obtener un rendimiento logarítmico.
Implementación de algoritmos de ordenamiento: Escritura de algoritmos eficientes de ordenamiento, entendiendo sus ventajas y desventajas en diferentes escenarios. Análisis de complejidad: Comparación de la eficiencia de estos métodos en términos de Big O para diferentes tamaños y tipos de datos.
Procesamiento de cadenas: Implementación de algoritmos que analizan y manipulan cadenas de texto en función de requisitos específicos. Patrones y expresiones regulares: Uso de expresiones regulares para realizar coincidencias y reemplazos complejos dentro de cadenas de texto.