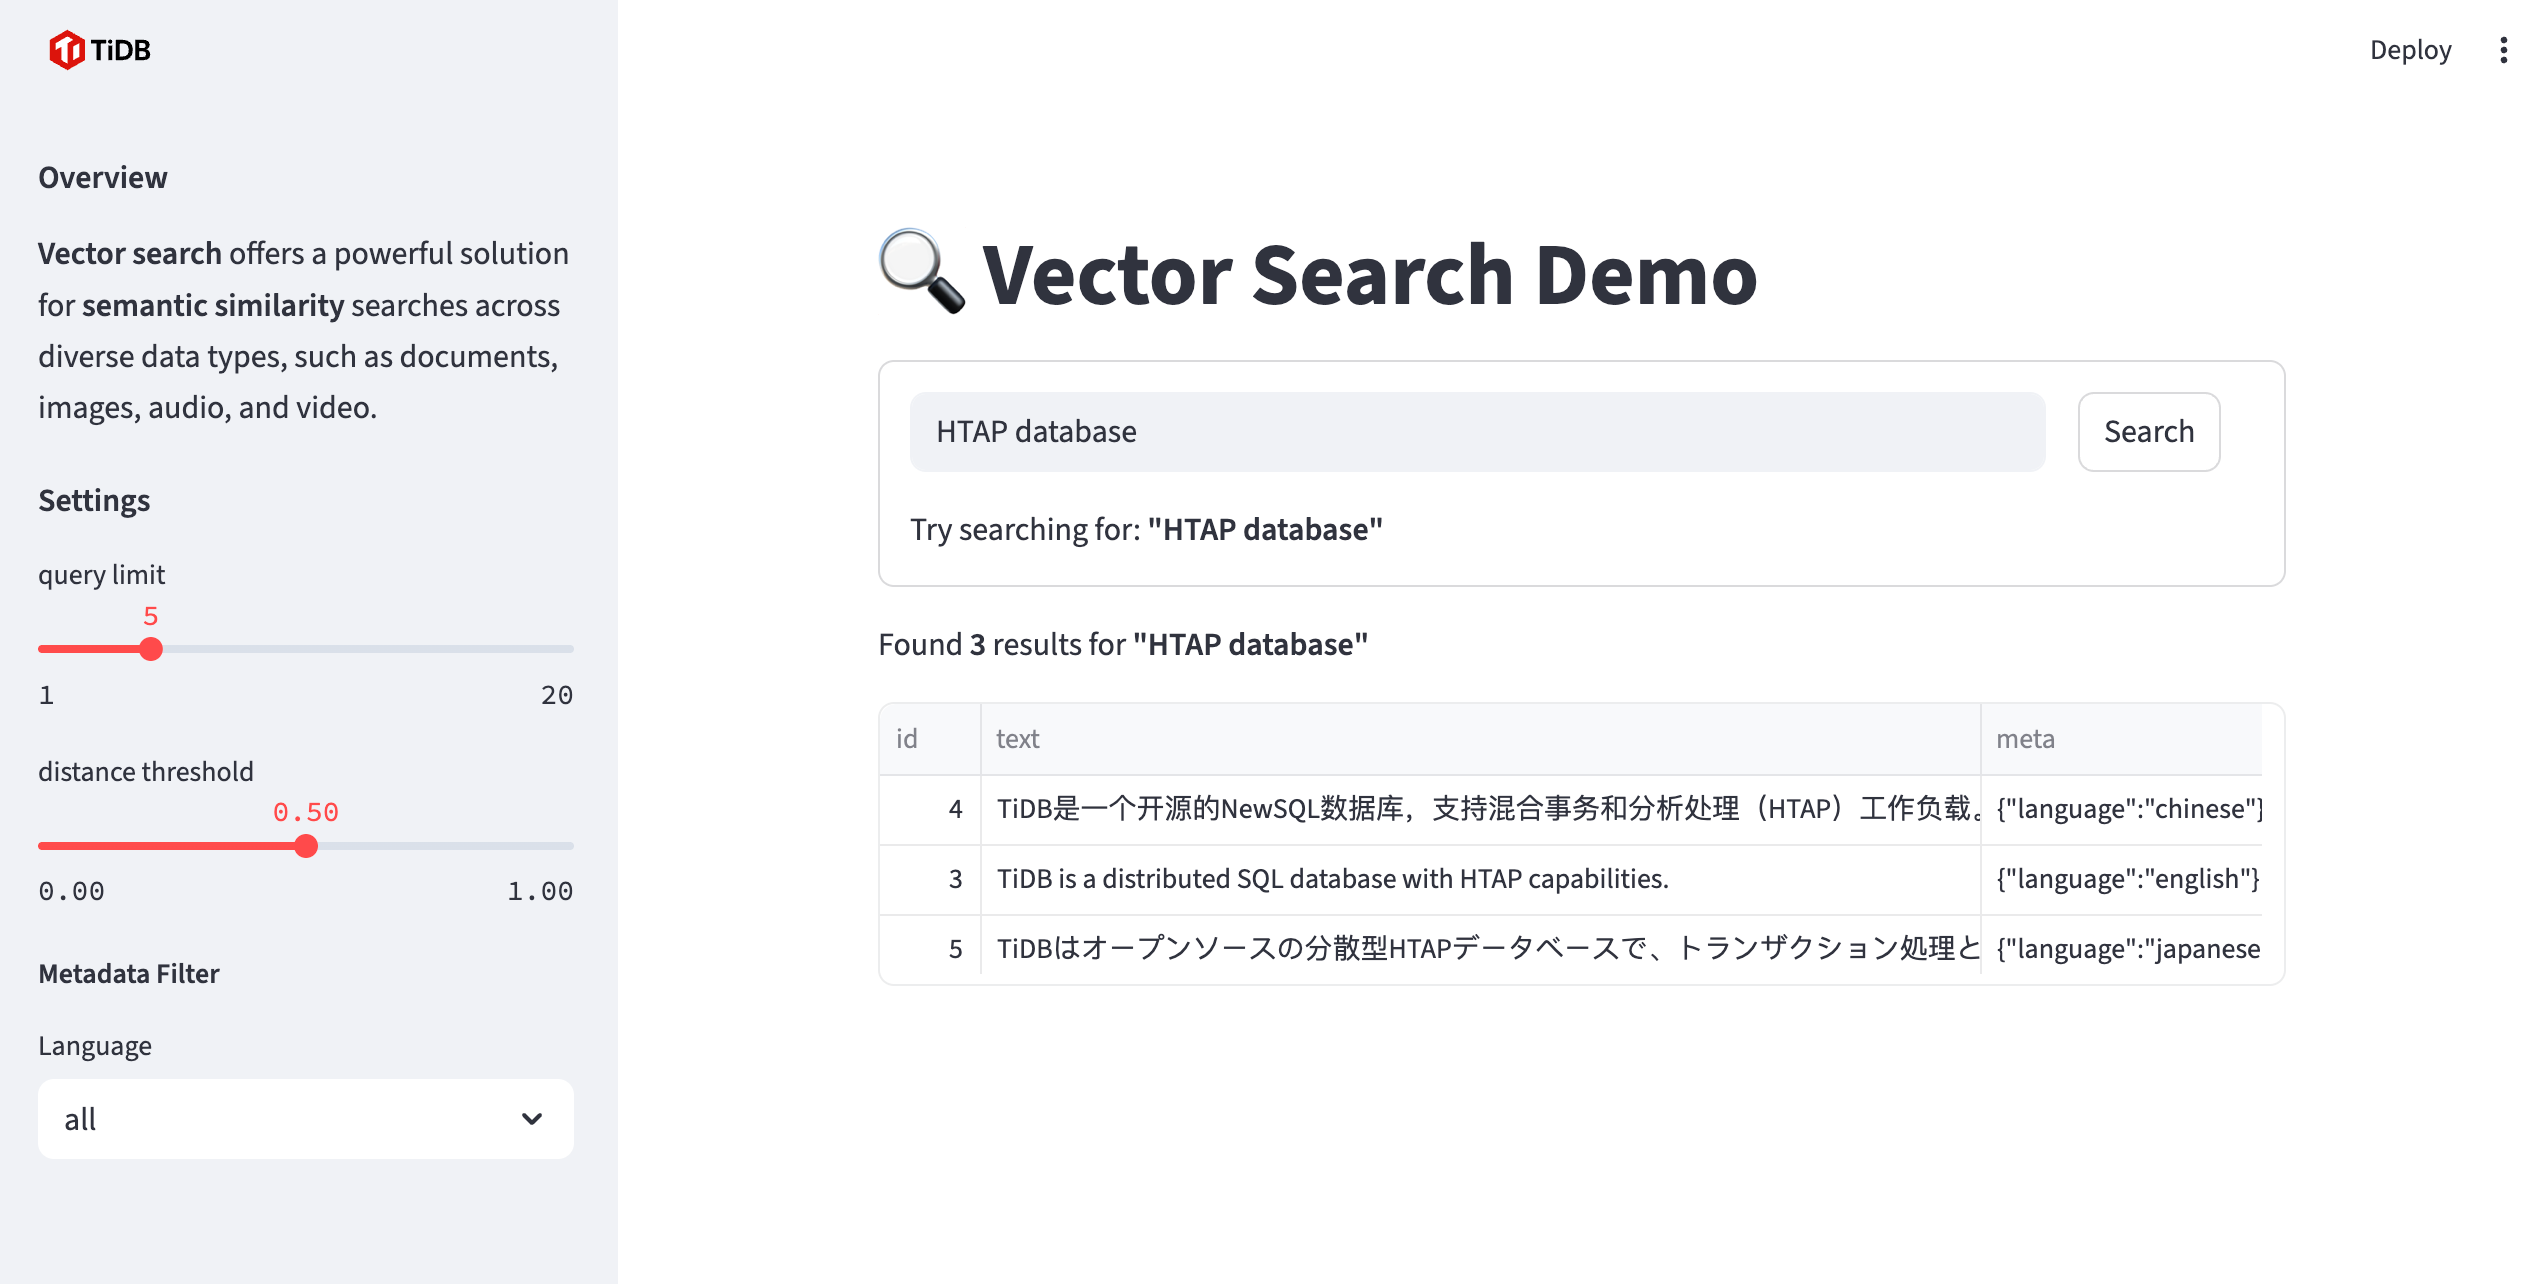
ベクトル埋め込みを用いた意味検索
+
ベクトル埋め込みを用いたセマンティック検索
## 前提条件 {#prerequisites} diff --git a/ai/integrations/embedding-openai-compatible.md b/ai/integrations/embedding-openai-compatible.md index a1dc1be528968..d7b979e96d84c 100644 --- a/ai/integrations/embedding-openai-compatible.md +++ b/ai/integrations/embedding-openai-compatible.md @@ -5,7 +5,7 @@ summary: TiDBベクトル検索をOpenAI互換の埋め込みモデルと統合 # OpenAI互換埋め込み {#openai-compatible-embeddings} -このチュートリアルでは、OpenAI互換の埋め込みサービスを使用してテキスト埋め込みを生成し、TiDBに保存し、意味検索を実行する方法を説明します。 +このチュートリアルでは、OpenAI互換の埋め込みサービスを使用してテキスト埋め込みを生成し、TiDBに保存し、セマンティック検索を実行する方法を説明します。 > **Note:** > diff --git a/ai/integrations/vector-search-auto-embedding-huggingface.md b/ai/integrations/vector-search-auto-embedding-huggingface.md index 99c50d2e8a5e0..ea71aca0698e1 100644 --- a/ai/integrations/vector-search-auto-embedding-huggingface.md +++ b/ai/integrations/vector-search-auto-embedding-huggingface.md @@ -6,7 +6,7 @@ aliases: ['/ja/tidbcloud/vector-search-auto-embedding-huggingface/'] # Hugging Face Embeddings {#hugging-face-embeddings} -このドキュメントでは、 TiDB Cloudで Hugging Face 埋め込みモデルを[自動埋め込み](/ai/integrations/vector-search-auto-embedding-overview.md)で使用する方法、テキストクエリによる意味検索を実行する方法について説明します。 +このドキュメントでは、 TiDB Cloudで Hugging Face 埋め込みモデルを[自動埋め込み](/ai/integrations/vector-search-auto-embedding-overview.md)で使用する方法、テキストクエリによるセマンティック検索を実行する方法について説明します。 > **Note:** > diff --git a/ai/integrations/vector-search-auto-embedding-openai.md b/ai/integrations/vector-search-auto-embedding-openai.md index 0bb4e9a8ce283..b07896dc122dd 100644 --- a/ai/integrations/vector-search-auto-embedding-openai.md +++ b/ai/integrations/vector-search-auto-embedding-openai.md @@ -6,7 +6,7 @@ aliases: ['/ja/tidbcloud/vector-search-auto-embedding-openai/'] # OpenAI埋め込み {#openai-embeddings} -このドキュメントでは、 TiDB Cloudで OpenAI 埋め込みモデルを[自動埋め込み](/ai/integrations/vector-search-auto-embedding-overview.md)で使用する方法、テキストクエリによる意味検索を実行する方法について説明します。 +このドキュメントでは、 TiDB Cloudで OpenAI 埋め込みモデルを[自動埋め込み](/ai/integrations/vector-search-auto-embedding-overview.md)で使用する方法、テキストクエリによるセマンティック検索を実行する方法について説明します。 > **Note:** > diff --git a/ai/integrations/vector-search-auto-embedding-overview.md b/ai/integrations/vector-search-auto-embedding-overview.md index 0738ab3f505ef..813e83a75569b 100644 --- a/ai/integrations/vector-search-auto-embedding-overview.md +++ b/ai/integrations/vector-search-auto-embedding-overview.md @@ -1,12 +1,12 @@ --- title: Auto Embedding Overview -summary: 自動埋め込み機能を使用して、ベクトルではなくプレーンテキストで意味検索を実行する方法を学びましょう。 +summary: 自動埋め込み機能を使用して、ベクトルではなくプレーンテキストでセマンティック検索を実行する方法を学びましょう。 aliases: ['/ja/tidbcloud/vector-search-auto-embedding-overview/'] --- # 自動埋め込みの概要 {#auto-embedding-overview} -自動埋め込み機能を使用すると、独自のベクトルを用意することなく、プレーンテキストで直接ベクトル検索を実行できます。この機能を使えば、テキストデータを直接挿入し、テキストクエリを使用して意味検索を実行できます。TiDBはバックグラウンドでテキストを自動的にベクトルに変換します。 +自動埋め込み機能を使用すると、独自のベクトルを用意することなく、プレーンテキストで直接ベクトル検索を実行できます。この機能を使えば、テキストデータを直接挿入し、テキストクエリを使用してセマンティック検索を実行できます。TiDBはバックグラウンドでテキストを自動的にベクトルに変換します。 自動埋め込み機能を使用するための基本的なワークフローは以下のとおりです。 @@ -24,7 +24,7 @@ aliases: ['/ja/tidbcloud/vector-search-auto-embedding-overview/'] > > Python の使用方法については、 [Pythonで自動埋め込みを使用する](#use-auto-embedding-in-python)を参照してください。 -以下の例は、コサイン距離を用いた自動埋め込み機能を使用して意味検索を実行する方法を示しています。この例では、APIキーは不要です。 +以下の例は、コサイン距離を用いた自動埋め込み機能を使用してセマンティック検索を実行する方法を示しています。この例では、APIキーは不要です。 ```sql -- Create a table with auto-embedding diff --git a/ai/integrations/vector-search-integrate-with-langchain.md b/ai/integrations/vector-search-integrate-with-langchain.md index b1af095e72ded..355babc1e534e 100644 --- a/ai/integrations/vector-search-integrate-with-langchain.md +++ b/ai/integrations/vector-search-integrate-with-langchain.md @@ -33,7 +33,7 @@ aliases: ['/ja/tidb/stable/vector-search-integrate-with-langchain/','/ja/tidb/de ## さあ始めましょう {#get-started} -このセクションでは、TiDBベクトル検索をLangChainと統合して意味検索を実行するための手順を段階的に説明します。 +このセクションでは、TiDBベクトル検索をLangChainと統合してセマンティック検索を実行するための手順を段階的に説明します。 ### ステップ1. 新しいJupyter Notebookファイルを作成する {#step-1-create-a-new-jupyter-notebook-file} @@ -465,7 +465,7 @@ TiDB Vector offers advanced, high-speed vector processing capabilities, enhancin このプロセスは主に2つのステップから構成されます。 -1. 空港レビュー全体を対象に意味検索を行い、希望する設備に一致する空港コードを特定します。 +1. 空港レビュー全体を対象にセマンティック検索を行い、希望する設備に一致する空港コードを特定します。 2. SQLクエリを実行してこれらのコードをルート情報と統合し、ユーザーの好みに合致する航空会社と目的地を強調表示します。 ### データの準備 {#prepare-data} diff --git a/ai/quickstart-via-python.md b/ai/quickstart-via-python.md index 8d69881d69ee6..d68463166d811 100644 --- a/ai/quickstart-via-python.md +++ b/ai/quickstart-via-python.md @@ -13,7 +13,7 @@ aliases: ['/ja/tidb/stable/vector-search-get-started-using-python/','/ja/tidb/de - TiDB Python SDKを使用してTiDBに接続します。 - 一般的な埋め込みモデルを使用してテキスト埋め込みを生成します。 - ベクトルをTiDBテーブルに格納します。 -- ベクトル類似度を用いて意味検索を実行します。 +- ベクトル類似度を用いてセマンティック検索を実行します。 > **Note:** > diff --git a/ai/vector-search-get-started-using-python.md b/ai/vector-search-get-started-using-python.md index 90ca078d96d2d..cb619cadf77db 100644 --- a/ai/vector-search-get-started-using-python.md +++ b/ai/vector-search-get-started-using-python.md @@ -199,7 +199,7 @@ vector_store.insert( ) ``` -### ステップ7.意味検索を実行する {#step-7-perform-semantic-search} +### ステップ7.セマンティック検索を実行する {#step-7-perform-semantic-search} このステップでは、"a swimming animal"という単語を検索しますが、既存の文書にはこの単語と直接一致するものはありません。 diff --git a/releases/release-8.4.0.md b/releases/release-8.4.0.md index 209e6620970eb..dd6b292423c4b 100644 --- a/releases/release-8.4.0.md +++ b/releases/release-8.4.0.md @@ -13,7 +13,7 @@ TiDB バージョン: 8.4.0 バージョン8.4.0では、以下の主要な機能と改善点が導入されています。 -| カテゴリ | 機能/改善点 | 説明 |
|---|---|---|
| 拡張性とパフォーマンス | インスタンスレベルの実行プランキャッシュ(実験的) | インスタンスレベルのプランキャッシュを使用すると、同じ TiDB インスタンス内のすべてのセッションでプランキャッシュを共有できます。セッションレベルのプランキャッシュと比較して、この機能はメモリに多くの実行計画をキャッシュすることで SQL コンパイル時間を短縮し、SQL 全体の実行時間を短縮します。これにより、OLTP のパフォーマンスとスループットが向上するとともに、メモリ使用量をより適切に制御し、データベースの安定性を高めることができます。 |
| パーティションテーブルのグローバルインデックス(GA) | グローバルインデックスを使用すると、パーティション化されていない列の取得効率を効果的に向上させることができ、一意キーにパーティションキーを含める必要があるという制約を取り除くことができます。この機能により、TiDBパーティションテーブルの使用シナリオが拡張され、データ移行に必要なアプリケーションの変更作業の一部が不要になります。 | |
| TSOリクエストの並列モード | 高並行処理環境では、この機能を使用することでTSOの取得待ち時間を短縮し、クラスタのスループットを向上させることができます。 | |
| キャッシュされたテーブルのクエリパフォーマンスを向上させる | キャッシュされたテーブルに対するインデックススキャンのクエリパフォーマンスが向上し、場合によっては最大5.4倍の改善が見られます。小規模なテーブルに対する高速クエリの場合、キャッシュされたテーブルを使用することで、全体的なパフォーマンスを大幅に向上させることができます。 | |
| 信頼性と可用性 | 暴走クエリに対するトリガーの追加と、リソースグループの切り替えのサポート | 暴走クエリは、予期しないSQLパフォーマンスの問題がシステムに与える影響を軽減する効果的な手段です。TiDB v8.4.0では、識別条件としてコプロセッサーによって処理されたキーの数( PROCESSED_KEYS )とリクエストユニット( RU )が導入され、識別されたクエリを指定されたリソースグループに配置することで、暴走クエリのより正確な識別と制御が可能になりました。 |
| リソース制御のバックグラウンドタスクにおけるリソース使用量の上限設定をサポートする | リソース制御のバックグラウンドタスクに最大パーセンテージ制限を設定することで、さまざまなアプリケーションシステムのニーズに基づいてリソース消費を制御できます。これにより、バックグラウンドタスクの消費量を低く抑え、オンラインサービスの品質を確保できます。 | |
| TiProxyはトラフィックのキャプチャと再生をサポートします(実験的)。 | TiProxyを使用して、クラスターのアップグレード、移行、デプロイメントの変更などの主要な操作を行う前に、TiDB本番クラスターから実際のワークロードをキャプチャします。これらのワークロードをターゲットのテストクラスターで再生することで、パフォーマンスを検証し、変更が確実に成功することを確認します。 | |
| 同時自動統計収集 | TiDBクラスタ内での同時実行自動分析操作の数を制御するために、システム変数tidb_auto_analyze_concurrencyを導入します。TiDBは、ノードの規模とハードウェア仕様に基づいて、スキャンタスクの同時実行数を自動的に決定します。これにより、システムリソースを最大限に活用して統計情報の収集効率が向上し、手動による調整が削減され、クラスタの安定したパフォーマンスが確保されます。 | |
| SQL | ベクトル検索(実験的) | ベクトル検索は、データの意味論に基づいた検索手法であり、より関連性の高い検索結果を提供します。AIや大規模言語モデル(LLM)の中核関数の一つとして、ベクトル検索は、検索拡張生成(RAG)、意味検索、推薦システムなど、さまざまなシナリオで活用できます。 |
| データベースの運用と可観測性 | TiKVとTiDBのCPU時間をメモリテーブルに表示する | CPU時間はシステムテーブルに統合され、セッションやSQLなどの他のメトリックと並べて表示されるようになりました。これにより、CPU使用率の高い操作を複数の視点から把握し、診断効率を向上させることができます。これは、インスタンスにおけるCPUスパイクやクラスタにおける読み書きホットスポットなどのシナリオを診断する際に特に役立ちます。 |
| テーブルまたはデータベースごとに集計されたTiKV CPU時間を表示する機能をサポートします。 | ホットスポットの問題が個々のSQL文によって引き起こされていない場合、 Top SQLでテーブルまたはデータベースレベルごとに集計されたCPU時間を使用することで、ホットスポットの原因となっているテーブルやアプリケーションを迅速に特定でき、ホットスポットやCPU消費の問題の診断効率を大幅に向上させることができます。 | |
| IMDSv2サービスが有効になっているTiKVインスタンスのバックアップをサポートします。 | AWS EC2 では、デフォルトのメタデータサービスとして IMDSv2 が使用されるようになりました。TiDB は、IMDSv2 が有効になっている TiKV インスタンスからのデータバックアップをサポートしており、パブリッククラウド サービスで TiDB クラスターをより効率的に実行するのに役立ちます。 | |
| Security | ログバックアップデータのクライアント側暗号化(実験的) | ログバックアップデータをバックアップストレージにアップロードする前に、バックアップデータを暗号化することで、保管中および転送中のセキュリティを確保できます。 |
| カテゴリ | 機能/改善点 | 説明 |
|---|---|---|
| 拡張性とパフォーマンス | インスタンスレベルの実行プランキャッシュ(実験的) | インスタンスレベルのプランキャッシュを使用すると、同じ TiDB インスタンス内のすべてのセッションでプランキャッシュを共有できます。セッションレベルのプランキャッシュと比較して、この機能はメモリに多くの実行計画をキャッシュすることで SQL コンパイル時間を短縮し、SQL 全体の実行時間を短縮します。これにより、OLTP のパフォーマンスとスループットが向上するとともに、メモリ使用量をより適切に制御し、データベースの安定性を高めることができます。 |
| パーティションテーブルのグローバルインデックス(GA) | グローバルインデックスを使用すると、パーティション化されていない列の取得効率を効果的に向上させることができ、一意キーにパーティションキーを含める必要があるという制約を取り除くことができます。この機能により、TiDBパーティションテーブルの使用シナリオが拡張され、データ移行に必要なアプリケーションの変更作業の一部が不要になります。 | |
| TSOリクエストの並列モード | 高並行処理環境では、この機能を使用することでTSOの取得待ち時間を短縮し、クラスタのスループットを向上させることができます。 | |
| キャッシュされたテーブルのクエリパフォーマンスを向上させる | キャッシュされたテーブルに対するインデックススキャンのクエリパフォーマンスが向上し、場合によっては最大5.4倍の改善が見られます。小規模なテーブルに対する高速クエリの場合、キャッシュされたテーブルを使用することで、全体的なパフォーマンスを大幅に向上させることができます。 | |
| 信頼性と可用性 | 暴走クエリに対するトリガーの追加と、リソースグループの切り替えのサポート | 暴走クエリは、予期しないSQLパフォーマンスの問題がシステムに与える影響を軽減する効果的な手段です。TiDB v8.4.0では、識別条件としてコプロセッサーによって処理されたキーの数( PROCESSED_KEYS )とリクエストユニット( RU )が導入され、識別されたクエリを指定されたリソースグループに配置することで、暴走クエリのより正確な識別と制御が可能になりました。 |
| リソース制御のバックグラウンドタスクにおけるリソース使用量の上限設定をサポートする | リソース制御のバックグラウンドタスクに最大パーセンテージ制限を設定することで、さまざまなアプリケーションシステムのニーズに基づいてリソース消費を制御できます。これにより、バックグラウンドタスクの消費量を低く抑え、オンラインサービスの品質を確保できます。 | |
| TiProxyはトラフィックのキャプチャと再生をサポートします(実験的)。 | TiProxyを使用して、クラスターのアップグレード、移行、デプロイメントの変更などの主要な操作を行う前に、TiDB本番クラスターから実際のワークロードをキャプチャします。これらのワークロードをターゲットのテストクラスターで再生することで、パフォーマンスを検証し、変更が確実に成功することを確認します。 | |
| 同時自動統計収集 | TiDBクラスタ内での同時実行自動分析操作の数を制御するために、システム変数tidb_auto_analyze_concurrencyを導入します。TiDBは、ノードの規模とハードウェア仕様に基づいて、スキャンタスクの同時実行数を自動的に決定します。これにより、システムリソースを最大限に活用して統計情報の収集効率が向上し、手動による調整が削減され、クラスタの安定したパフォーマンスが確保されます。 | |
| SQL | ベクトル検索(実験的) | ベクトル検索は、データの意味論に基づいた検索手法であり、より関連性の高い検索結果を提供します。AIや大規模言語モデル(LLM)の中核関数の一つとして、ベクトル検索は、検索拡張生成(RAG)、セマンティック検索、推薦システムなど、さまざまなシナリオで活用できます。 |
| データベースの運用と可観測性 | TiKVとTiDBのCPU時間をメモリテーブルに表示する | CPU時間はシステムテーブルに統合され、セッションやSQLなどの他のメトリックと並べて表示されるようになりました。これにより、CPU使用率の高い操作を複数の視点から把握し、診断効率を向上させることができます。これは、インスタンスにおけるCPUスパイクやクラスタにおける読み書きホットスポットなどのシナリオを診断する際に特に役立ちます。 |
| テーブルまたはデータベースごとに集計されたTiKV CPU時間を表示する機能をサポートします。 | ホットスポットの問題が個々のSQL文によって引き起こされていない場合、 Top SQLでテーブルまたはデータベースレベルごとに集計されたCPU時間を使用することで、ホットスポットの原因となっているテーブルやアプリケーションを迅速に特定でき、ホットスポットやCPU消費の問題の診断効率を大幅に向上させることができます。 | |
| IMDSv2サービスが有効になっているTiKVインスタンスのバックアップをサポートします。 | AWS EC2 では、デフォルトのメタデータサービスとして IMDSv2 が使用されるようになりました。TiDB は、IMDSv2 が有効になっている TiKV インスタンスからのデータバックアップをサポートしており、パブリッククラウド サービスで TiDB クラスターをより効率的に実行するのに役立ちます。 | |
| Security | ログバックアップデータのクライアント側暗号化(実験的) | ログバックアップデータをバックアップストレージにアップロードする前に、バックアップデータを暗号化することで、保管中および転送中のセキュリティを確保できます。 |
| カテゴリ | 機能/改善点 | 説明 |
|---|---|---|
| 拡張性とパフォーマンス | 複数の次元でデータ処理のレイテンシーを削減する | TiDBは、パフォーマンス向上のためにデータ処理を継続的に改良し、金融分野における低遅延SQL処理の要件を効果的に満たしています。主なアップデート内容は以下のとおりです。
|
| TiKV MVCC インメモリエンジン (IME) (バージョン8.5.0で導入) | TiKV MVCCのインメモリエンジンは、最新のMVCCバージョンのデータをメモリにキャッシュすることで、古いバージョンをスキップして最新のデータを迅速に取得できるようにします。この機能は、データレコードが頻繁に更新される場合や、履歴バージョンが長期間保持される場合に、データスキャン性能を大幅に向上させることができます。 | |
| アクティブなPDフォロワーを使用して、PDのリージョン情報クエリサービスを強化します(v8.5.0で一般提供開始)。 | TiDB v7.6.0 では、実験的機能"Active PD Follower"が導入されました。これにより、PD フォロワーがリージョン情報クエリサービスを提供できるようになります。この機能は、多数の TiDB ノードとリージョンを持つクラスターにおいて、PD クラスターがGetRegionおよびScanRegionsリクエストを処理する能力を向上させ、PD リーダーの CPU 負荷を軽減します。この機能は、v8.5.0 で一般提供 (GA) されます。 | |
| インスタンスレベルの実行プランキャッシュ(実験的、v8.4.0で導入) | インスタンスレベルのプランキャッシュを使用すると、同じ TiDB インスタンス内のすべてのセッションでプランキャッシュを共有できます。セッションレベルのプランキャッシュと比較して、この機能はメモリに多くの実行計画をキャッシュすることで SQL コンパイル時間を短縮し、SQL 全体の実行時間を短縮します。これにより、OLTP のパフォーマンスとスループットが向上するとともに、メモリ使用量をより適切に制御し、データベースの安定性を高めることができます。 | |
| パーティションテーブルのグローバルインデックス(バージョン8.4.0で一般提供開始) | グローバルインデックスは、パーティション化されていない列の取得効率を効果的に向上させ、一意キーにパーティションキーを含める必要があるという制約を取り除きます。この機能により、TiDBパーティションテーブルの利用シナリオが拡張され、パーティションテーブルのパフォーマンスが向上し、特定のクエリシナリオにおけるリソース消費量が削減されます。 | |
Projectionオペレーターをストレージエンジンにデフォルトでプッシュダウンする機能(v8.3.0で導入) | Projectionオペレーターをストレージエンジンにプッシュダウンすることで、ストレージノード全体に負荷を分散させ、ノード間のデータ転送量を削減できます。この最適化により、特定のSQLクエリの実行時間が短縮され、データベース全体のパフォーマンスが向上します。 | |
| 統計情報を収集する際に不要な列を無視する機能(バージョン8.3.0で導入) | オプティマイザが必要な情報を確実に取得できるという前提のもと、TiDBは統計情報の収集を高速化し、統計情報の適時性を向上させることで、最適な実行計画の選択を保証し、クラスタのパフォーマンスを向上させます。同時に、TiDBはシステムオーバーヘッドを削減し、リソース利用率も向上させます。 | |
| 信頼性と可用性 | 大規模クラスターの安定性を向上させる | TiDBを使用してマルチテナントアプリケーションやSaaSアプリケーションを運用する企業は、多くの場合、大量のテーブルを保存する必要があります。バージョン8.5.0では、TiDBは大規模クラスタの安定性を大幅に向上させました。
|
| 暴走クエリに対するトリガーの追加サポート、およびリソースグループの切り替えサポート(v8.4.0で導入) | 暴走クエリは、予期しないSQLパフォーマンスの問題がシステムに与える影響を軽減する効果的な手段です。TiDB v8.4.0では、識別条件としてコプロセッサーによって処理されたキーの数( PROCESSED_KEYS )とリクエストユニット( RU )が導入され、識別されたクエリを指定されたリソースグループに配置することで、暴走クエリのより正確な識別と制御が可能になりました。 | |
| リソース制御のバックグラウンドタスクにおけるリソース使用量の上限設定をサポート(実験的、v8.4.0で導入) | リソース制御のバックグラウンドタスクに最大パーセンテージ制限を設定することで、さまざまなアプリケーションシステムのニーズに基づいてリソース消費を制御できます。これにより、バックグラウンドタスクの消費量を低く抑え、オンラインサービスの品質を確保できます。 | |
| TiProxyのユースケースを強化および拡張する | TiDBの高可用性を実現する上で重要なコンポーネントであるTiProxyは、SQLトラフィックのアクセスと転送にとどまらず、クラスタ変更の評価をサポートする機能も備えています。主な機能は以下のとおりです。
| |
| TiDBの並列HashAggアルゴリズムはディスクスピルをサポートしています(v8.2.0でGA対応)。 | HashAgg は、同じフィールド値を持つ行を効率的に集計するために TiDB で広く使用されている集計オペレーターです。TiDB v8.0.0 では、処理速度をさらに向上させる実験的機能として parallel HashAgg が導入されました。メモリリソースが不足している場合、parallel HashAgg は一時的にソートされたデータをディスクに書き出すことで、過剰なメモリ使用による潜在的な OOM リスクを回避します。これにより、ノードの安定性を維持しながらクエリパフォーマンスが向上します。v8.2.0 では、この機能が一般提供 (GA) となり、デフォルトで有効になっているため、 tidb_executor_concurrencyを使用して parallel HashAgg の同時実行性を安全に構成できます。 | |
| SQL | 外部キー(バージョン8.5.0でGA対応) | 外部キーは、データベースにおける制約であり、テーブル間の関係を確立し、データの一貫性と整合性を確保します。外部キーは、子テーブルで参照されるデータが親テーブルに存在することを保証し、無効なデータの挿入を防ぎます。また、外部キーはカスケード操作(削除や更新時の自動同期など)をサポートし、ビジネスロジックの実装を簡素化し、データ関係を手動で維持する複雑さを軽減します。 |
| ベクトル検索(実験的、v8.4.0で導入) | ベクトル検索は、データの意味論に基づいた検索手法であり、より関連性の高い検索結果を提供します。AIや大規模言語モデル(LLM)の中核関数の一つとして、ベクトル検索は、検索拡張生成(RAG)、意味検索、推薦システムなど、さまざまなシナリオで活用できます。 | |
| データベースの運用と可観測性 | TiKVおよびTiDBのCPU時間をメモリテーブルに表示する(バージョン8.4.0で導入) | CPU時間はシステムテーブルに統合され、セッションやSQLなどの他のメトリックと並べて表示されるようになりました。これにより、CPU使用率の高い操作を複数の視点から把握し、診断効率を向上させることができます。これは、インスタンスにおけるCPUスパイクやクラスタにおける読み書きホットスポットなどのシナリオを診断する際に特に役立ちます。 |
| TiKVのCPU時間をテーブル別またはデータベース別に集計して表示する機能をサポート(v8.4.0で導入) | ホットスポットの問題が個々のSQL文によって引き起こされていない場合、 Top SQLでテーブルまたはデータベースレベルごとに集計されたCPU時間を使用することで、ホットスポットの原因となっているテーブルやアプリケーションを迅速に特定でき、ホットスポットやCPU消費の問題の診断効率を大幅に向上させることができます。 | |
| Backup & Restore (BR)は、 AWS SDK for Rustを使用して外部ストレージにアクセスします (v8.5.0 で導入)。 | BRは、TiKVからAmazon S3などの外部ストレージにアクセスするために、元のRusotoライブラリをAWS SDK for Rustに置き換えます。この変更により、 IMDSv2やEKS Pod IdentityなどのAWS機能との互換性が向上します。 | |
| Security | スナップショットバックアップデータおよびログバックアップデータのクライアント側暗号化(v8.5.0で一般提供開始) | バックアップデータをバックアップストレージにアップロードする前に、バックアップデータを暗号化することで、保管中および転送中のセキュリティを確保できます。 |
| カテゴリ | 機能/改善点 | 説明 |
|---|---|---|
| 拡張性とパフォーマンス | 複数の次元でデータ処理のレイテンシーを削減する | TiDBは、パフォーマンス向上のためにデータ処理を継続的に改良し、金融分野における低遅延SQL処理の要件を効果的に満たしています。主なアップデート内容は以下のとおりです。
|
| TiKV MVCC インメモリエンジン (IME) (バージョン8.5.0で導入) | TiKV MVCCのインメモリエンジンは、最新のMVCCバージョンのデータをメモリにキャッシュすることで、古いバージョンをスキップして最新のデータを迅速に取得できるようにします。この機能は、データレコードが頻繁に更新される場合や、履歴バージョンが長期間保持される場合に、データスキャン性能を大幅に向上させることができます。 | |
| アクティブなPDフォロワーを使用して、PDのリージョン情報クエリサービスを強化します(v8.5.0で一般提供開始)。 | TiDB v7.6.0 では、実験的機能"Active PD Follower"が導入されました。これにより、PD フォロワーがリージョン情報クエリサービスを提供できるようになります。この機能は、多数の TiDB ノードとリージョンを持つクラスターにおいて、PD クラスターがGetRegionおよびScanRegionsリクエストを処理する能力を向上させ、PD リーダーの CPU 負荷を軽減します。この機能は、v8.5.0 で一般提供 (GA) されます。 | |
| インスタンスレベルの実行プランキャッシュ(実験的、v8.4.0で導入) | インスタンスレベルのプランキャッシュを使用すると、同じ TiDB インスタンス内のすべてのセッションでプランキャッシュを共有できます。セッションレベルのプランキャッシュと比較して、この機能はメモリに多くの実行計画をキャッシュすることで SQL コンパイル時間を短縮し、SQL 全体の実行時間を短縮します。これにより、OLTP のパフォーマンスとスループットが向上するとともに、メモリ使用量をより適切に制御し、データベースの安定性を高めることができます。 | |
| パーティションテーブルのグローバルインデックス(バージョン8.4.0で一般提供開始) | グローバルインデックスは、パーティション化されていない列の取得効率を効果的に向上させ、一意キーにパーティションキーを含める必要があるという制約を取り除きます。この機能により、TiDBパーティションテーブルの利用シナリオが拡張され、パーティションテーブルのパフォーマンスが向上し、特定のクエリシナリオにおけるリソース消費量が削減されます。 | |
Projectionオペレーターをストレージエンジンにデフォルトでプッシュダウンする機能(v8.3.0で導入) | Projectionオペレーターをストレージエンジンにプッシュダウンすることで、ストレージノード全体に負荷を分散させ、ノード間のデータ転送量を削減できます。この最適化により、特定のSQLクエリの実行時間が短縮され、データベース全体のパフォーマンスが向上します。 | |
| 統計情報を収集する際に不要な列を無視する機能(バージョン8.3.0で導入) | オプティマイザが必要な情報を確実に取得できるという前提のもと、TiDBは統計情報の収集を高速化し、統計情報の適時性を向上させることで、最適な実行計画の選択を保証し、クラスタのパフォーマンスを向上させます。同時に、TiDBはシステムオーバーヘッドを削減し、リソース利用率も向上させます。 | |
| 信頼性と可用性 | 大規模クラスターの安定性を向上させる | TiDBを使用してマルチテナントアプリケーションやSaaSアプリケーションを運用する企業は、多くの場合、大量のテーブルを保存する必要があります。バージョン8.5.0では、TiDBは大規模クラスタの安定性を大幅に向上させました。
|
| 暴走クエリに対するトリガーの追加サポート、およびリソースグループの切り替えサポート(v8.4.0で導入) | 暴走クエリは、予期しないSQLパフォーマンスの問題がシステムに与える影響を軽減する効果的な手段です。TiDB v8.4.0では、識別条件としてコプロセッサーによって処理されたキーの数( PROCESSED_KEYS )とリクエストユニット( RU )が導入され、識別されたクエリを指定されたリソースグループに配置することで、暴走クエリのより正確な識別と制御が可能になりました。 | |
| リソース制御のバックグラウンドタスクにおけるリソース使用量の上限設定をサポート(実験的、v8.4.0で導入) | リソース制御のバックグラウンドタスクに最大パーセンテージ制限を設定することで、さまざまなアプリケーションシステムのニーズに基づいてリソース消費を制御できます。これにより、バックグラウンドタスクの消費量を低く抑え、オンラインサービスの品質を確保できます。 | |
| TiProxyのユースケースを強化および拡張する | TiDBの高可用性を実現する上で重要なコンポーネントであるTiProxyは、SQLトラフィックのアクセスと転送にとどまらず、クラスタ変更の評価をサポートする機能も備えています。主な機能は以下のとおりです。
| |
| TiDBの並列HashAggアルゴリズムはディスクスピルをサポートしています(v8.2.0でGA対応)。 | HashAgg は、同じフィールド値を持つ行を効率的に集計するために TiDB で広く使用されている集計オペレーターです。TiDB v8.0.0 では、処理速度をさらに向上させる実験的機能として parallel HashAgg が導入されました。メモリリソースが不足している場合、parallel HashAgg は一時的にソートされたデータをディスクに書き出すことで、過剰なメモリ使用による潜在的な OOM リスクを回避します。これにより、ノードの安定性を維持しながらクエリパフォーマンスが向上します。v8.2.0 では、この機能が一般提供 (GA) となり、デフォルトで有効になっているため、 tidb_executor_concurrencyを使用して parallel HashAgg の同時実行性を安全に構成できます。 | |
| SQL | 外部キー(バージョン8.5.0でGA対応) | 外部キーは、データベースにおける制約であり、テーブル間の関係を確立し、データの一貫性と整合性を確保します。外部キーは、子テーブルで参照されるデータが親テーブルに存在することを保証し、無効なデータの挿入を防ぎます。また、外部キーはカスケード操作(削除や更新時の自動同期など)をサポートし、ビジネスロジックの実装を簡素化し、データ関係を手動で維持する複雑さを軽減します。 |
| ベクトル検索(実験的、v8.4.0で導入) | ベクトル検索は、データの意味論に基づいた検索手法であり、より関連性の高い検索結果を提供します。AIや大規模言語モデル(LLM)の中核関数の一つとして、ベクトル検索は、検索拡張生成(RAG)、セマンティック検索、推薦システムなど、さまざまなシナリオで活用できます。 | |
| データベースの運用と可観測性 | TiKVおよびTiDBのCPU時間をメモリテーブルに表示する(バージョン8.4.0で導入) | CPU時間はシステムテーブルに統合され、セッションやSQLなどの他のメトリックと並べて表示されるようになりました。これにより、CPU使用率の高い操作を複数の視点から把握し、診断効率を向上させることができます。これは、インスタンスにおけるCPUスパイクやクラスタにおける読み書きホットスポットなどのシナリオを診断する際に特に役立ちます。 |
| TiKVのCPU時間をテーブル別またはデータベース別に集計して表示する機能をサポート(v8.4.0で導入) | ホットスポットの問題が個々のSQL文によって引き起こされていない場合、 Top SQLでテーブルまたはデータベースレベルごとに集計されたCPU時間を使用することで、ホットスポットの原因となっているテーブルやアプリケーションを迅速に特定でき、ホットスポットやCPU消費の問題の診断効率を大幅に向上させることができます。 | |
| Backup & Restore (BR)は、 AWS SDK for Rustを使用して外部ストレージにアクセスします (v8.5.0 で導入)。 | BRは、TiKVからAmazon S3などの外部ストレージにアクセスするために、元のRusotoライブラリをAWS SDK for Rustに置き換えます。この変更により、 IMDSv2やEKS Pod IdentityなどのAWS機能との互換性が向上します。 | |
| Security | スナップショットバックアップデータおよびログバックアップデータのクライアント側暗号化(v8.5.0で一般提供開始) | バックアップデータをバックアップストレージにアップロードする前に、バックアップデータを暗号化することで、保管中および転送中のセキュリティを確保できます。 |